
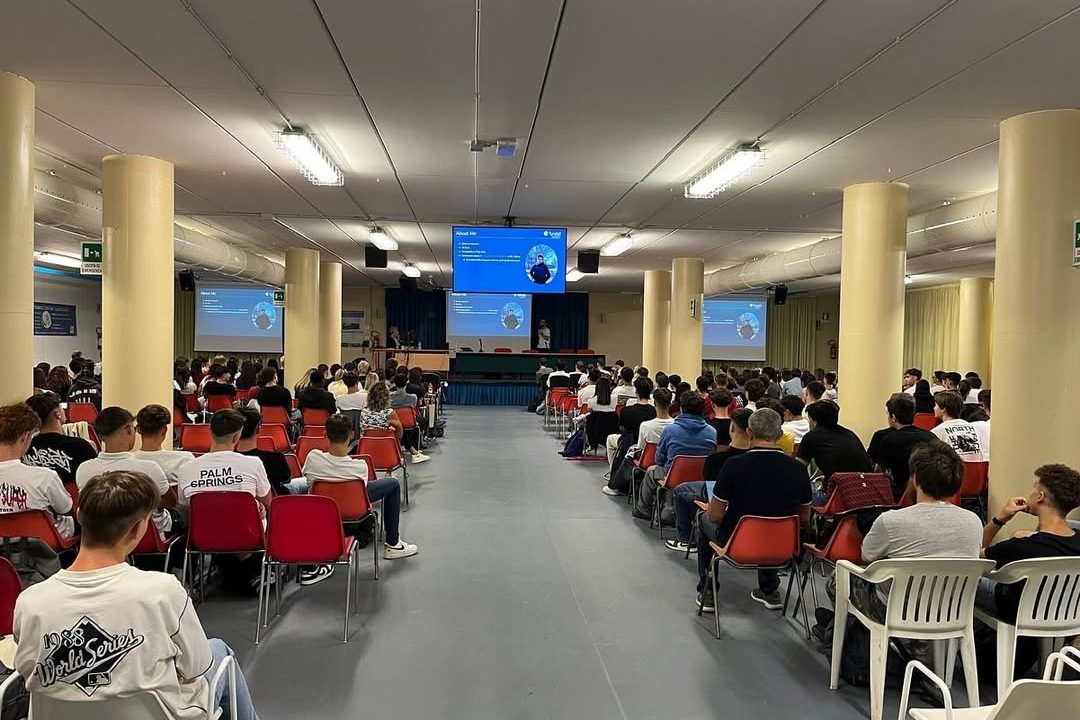
Il 12 settembre si è svolto, nell’Aula Magna dell’l’I.I.S. Einaudi Scarpa, per gli studenti delle classi quinte dell’indirizzo tecnologico, un incontro informativo sull’intelligenza artificiale con Simone Innocente e Andrea Visentin, rispettivamente ex studenti degli istituti Einaudi e Levi.
Simone, laureato in Informatica e specializzato in Intelligenza Artificiale presso l’università di Padova e attualmente dottorando in biofotonica a Cork (Irlanda), ha orientato il suo percorso di studi verso il machine learning. In particolare, durante i tirocini svolti nel percorso triennale, ha sviluppato modelli in grado di effettuare previsioni finanziarie in base all’analisi di dati storici. Dopo la laurea magistrale, ha trascorso un semestre in Estonia, approfondendo ulteriormente le sue conoscenze. Altri suoi progetti personali degni di nota sono quelli relativi ai modelli in grado di riconoscere i tratti facciali, e un altro in grado di trovare collegamenti relativi ad articoli sul Covid in Internet.
Attualmente, Simone studia l’uso dell’IA nella biofotonica medica e, nel suo caso, alla diagnosi del cancro orale. «Il nostro goal è quello di sviluppare una procedura di screening per diagnosticare il cancro o qualsiasi altra lesione maligna alla bocca, mediante l’analisi della saliva» – ha messo in luce il ricercatore – e «stiamo raccogliendo dei dati da diversi pazienti, con e senza cancro orale, che verranno poi usati per realizzare il nostro modello di IA». Infine, Simone ha spiegato brevemente gli altri passi necessari all’allenamento di modelli IA, come il filtraggio dei dati usati.
Andrea, invece, laureato in Ingegneria Informatica, sempre presso l’università di Padova, attualmente professore associato all’università di Cork in Data Analytics e Mining. Precedentemente aveva completato un dottorato di ricerca presso l’Insight Centre for Data Analytics. Assieme al suo team, lavora su applicazioni dell’IA in campo medico, previsioni finanziarie, supporto legale, ecc.
Al contrario di Simone, che ha illustrato il suo percorso di studi, Andrea ha offerto un’analisi sul funzionamento dell’IA e dei suoi aspetti etici. «Siamo abituati a pensare che il pregiudizio sia una componente umana, e non ci immaginiamo che un dispositivo tecnologico possa discriminare» – ha affermato Andrea – però ciò succede». Ma sono stati i programmatori a implementare un bias razzista e/o sessista nell’IA? «Fortunatamente no; questo è dovuto al modo in cui impara l’IA, ovvero per imitazione» – ha detto Andrea – spiegando il funzionamento del machine learning, ed esponendo le ampie limitazioni che questo metodo di allenamento comprende. Quindi, se l’IA ha un bias, significa che i dati con cui è stata addestrata contengono parti non eque di dati. Il concetto è riassunto nella frase comunemente usata «shit in, shit out», riferendosi al fatto che l’IA non può essere migliore dei dati con cui è stata allenata.
La soluzione? «Mettiamo delle “pezze” al modello, forzandolo a generare dei contenuti equi e inclusivi – ha dichiarato lo studioso – ma in fondo, l’IA ha sempre un bias; stiamo solo mettendo una pezza: correggere questi pregiudizi dell’IA è estremamente complesso.».
Andrea infine ha mostrato come l’IA stia aumentando esponenzialmente di complessità negli ultimi anni, e come sia necessario porre regolamentazioni a livello europeo, soprattutto per la privacy. La prima legislazione in questo ambito è entrata in vigore l’8 agosto, ma si tratta solo di un primo passo..
Alla fine del suo intervento abbiamo posto alcune domande al professore
Che tipo di infrastrutture informatiche sono necessarie per poter costruire algoritmi che avete usato voi, per esempio, nei vostri progetti personali?
L’IA ha moltissimi livelli di complessità; tutto dipende dal task che volete svolgere e da quanti dati volete usare. Nel lavoro che fa Simone, per esempio, è più che sufficiente un computer di casa, senza bisogno di grandi strumenti informatici.
Lei ha detto che molti modelli generativi sono censurati. Quanto è facile aggirare questa censura per dei malintenzionati?
Finchè vengono poste “pezze” esisterà sempre un modo per aggirarle. Il problema di fondo è che l’unico modo per risolvere questo problema sarà di sviluppare algoritmi totalmente diversi che siano in grado di comprendere concetti su ciò che è giusto e ciò che è sbagliato; tuttavia noi per ora non abbiamo ancora i mezzi per portare a compimento tale obiettivo».
